分享下双卡AMD R9700跑一下qwen3.8-27b效果(转载)
转载自 抡锤者论坛,原作者:罗冰寒,原帖《分享下双卡AMD R9700跑一下qwen3.8-27b效果》
之前玩AI入的N卡看涨价厉害卖了。。。但实在又想玩AI本地部署(文本和视频都想玩),又入了两张r9700,今天刚点亮,跑个qwen3.8 27b给大家分享下
硬件配置:
操作系统:Ubuntu 24.04,内核 7.0.0-30-generic
CPU:Intel Core Ultra 7 270K Plus(Arrow Lake)
- 24 核,最高频率 5.5 GHz
内存:64GB(系统识别 62GiB,当前空闲约 29GB)
显卡:2× AMD Radeon AI PRO R9700(工作站版,RDNA4/gfx1201)
-
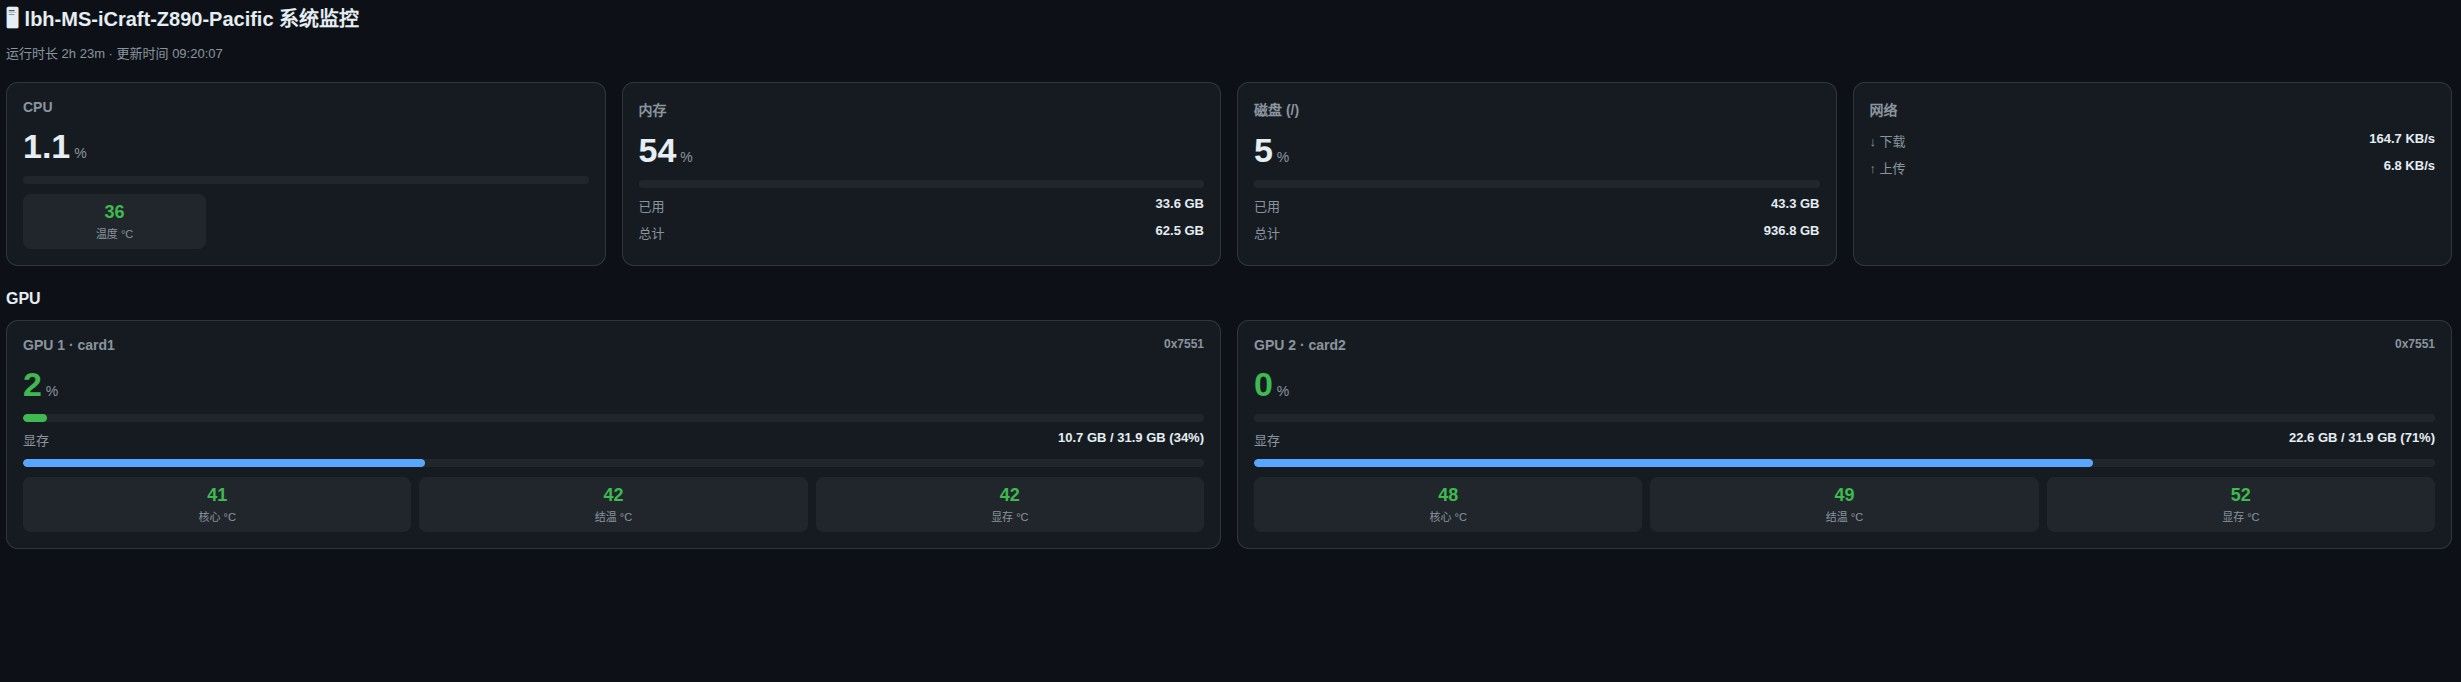
单卡 32GB GDDR6,可用显存各 31.9 GiB
-
PCI ID 1002:7551
-
双卡拓扑:PCIe 5.0 板内拆分 x8 + x8(主板 BIOS 启用)
-
card1 = 04:00.0(本地直连,承担显示输出)
-
card2 = 07:00.0(经 RPC 挂载,纯计算)
-
驱动:Mesa RADV 25.2.8(Vulkan),内核 amdgpu
-
未安装 ROCm(因此 llama.cpp 走 Vulkan 后端)
主板:铭瑄 iCraft Z890 Pacific(Intel Z890 芯片组)
工具
一、当前工具/部署栈
-
llama.cpp b10568(Vulkan 预编译版)+ ggml-rpc-server(RPC 双卡桥)
-
模型:Qwen3.8-27B unsloth UD-Q6_K_L(6-bit 动态量化,22.5GB)
-
草稿模型:mtp-Qwen3.8-27B-Q4_0(1.37GB,MTP 投机解码用)
-
GPU:Mesa RADV 25.2.8 驱动(RDNA4 gfx1201 原生支持)
-
服务器参数:128K 上下文、-cram 40000、-fa on、-np 1、--agent、--jinja
【二、已生效的加速机制】
-
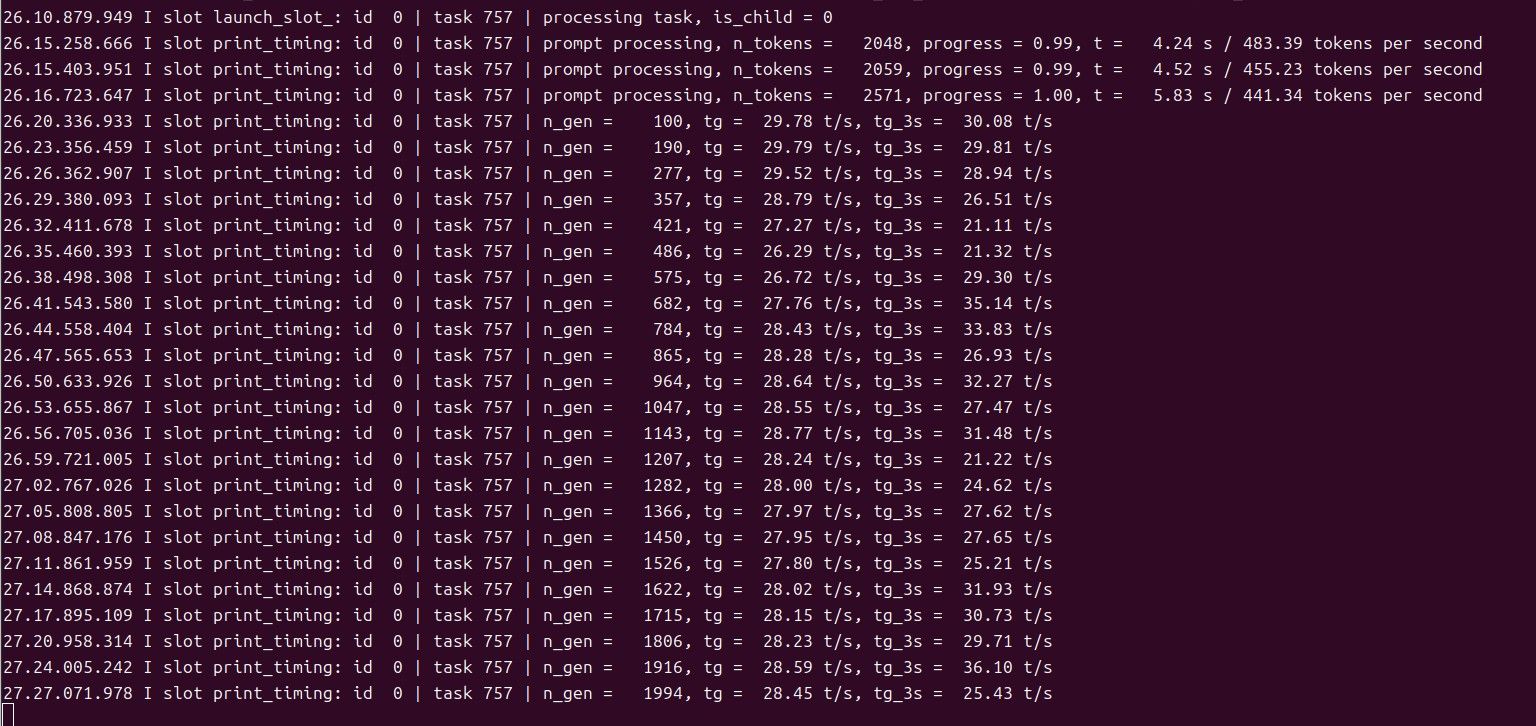
MTP 投机解码:--spec-type draft-mtp + Q4 草稿模型(--spec-draft-n-max 3)。效果最显著:生成从 21 → 36-49 tok/s(约 1.6-2.3x),接受率实测 0.41-0.88
-
双卡并行:layer split 流水线 + RPC,权重和 128K KV cache 按显存比例分摊(card1 1/3、card2 2/3),两卡实测负载 30%/69%
-
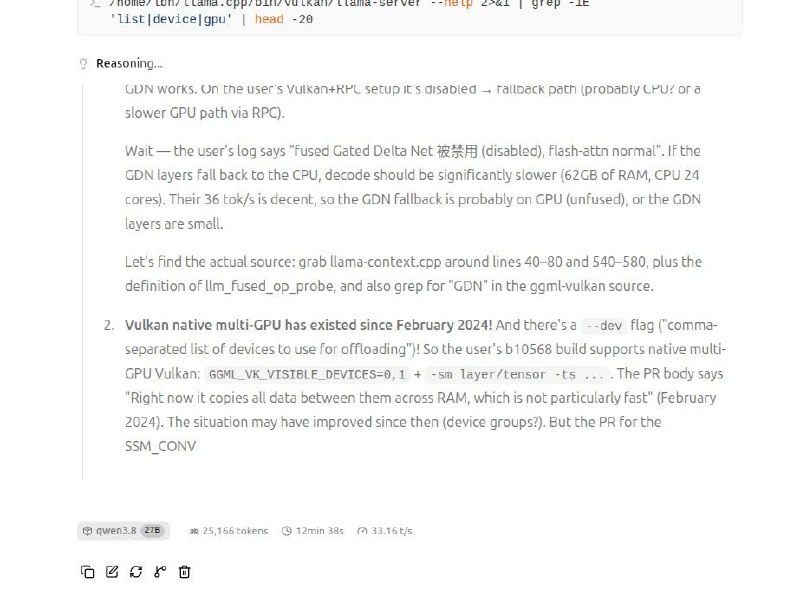
Flash Attention:-fa on(注意:日志显示 fused Gated Delta Net 被禁用,flash-attn 正常)
-
UD 动态量化:unsloth 的 Q6_K_L 质量接近 Q8、体积只有 24GB,带宽友好
-
KV cache 双卡分摊:128K 上下文 KV 全在显存(无 RAM 回退),这是 128K 下仍保持 36 tok/s 的关键
-
Prompt caching(自动):日志 graphs reused / LCP similarity 显示上下文复用已在工作,重复 prompt 命中缓存
-
单槽位(-np 1):避免多槽 KV 碎片
-
模型 mmap 加载:启动 17 秒,内存映射零拷贝
效果
-
生成(tg):36 tok/s 稳定,短对话峰值 49 tok/s
-
prompt 处理(pp):短 prompt 497 t/s,长 prompt(375 tokens)280 t/s
-
这是 27B 稠密模型 Q6 在双 R9700 上的成绩
版权归原作者「罗冰寒」所有,如有侵权请联系删除。
请登录后发表回复